本篇文章将介绍数据结构与算法的基本概念(前端版)。
去年这个时间我在写数据结构与算法的博文,今年还在写,令人感叹。
基础
算法的基本概念
算法(Algorithm)是指解题方案的准确而完整的描述,是一系列解决问题的清晰指令,算法代表着用系统的方法描述解决问题的策略机制
也就是说,能够对一定规范的输入,在有限时间内获得所要求的输出
算法的五大特性:
- 有限性(
Finiteness):一个算法必须保证执行有限步之后结束
- 确切性(
Definiteness): 一个算法的每一步骤必须有确切的定义
- 输入(
Input):一个算法有零个或多个输入,以刻画运算对象的初始情况,所谓零个输入是指算法本身给定了初始条件
- 输出(
Output):一个算法有一个或多个输出。没有输出的算法毫无意义
- 可行性(
Effectiveness):算法中执行的任何计算步骤都是可以被分解为基本的可执行的操作步骤,即每个计算步骤都可以在有限时间内完成(也称之为有效性
算法的复杂度
时间复杂度是指执行一个算法所需要的计算工作量,它反映了算法的执行效率和数据规模的关系。我们通常用大 O 符号来表示时间复杂度,例如O(n)、O(logn)、O(n2)等。时间复杂度越小,算法的效率越高。
空间复杂度是指执行一个算法所需要的内存空间,它反映了算法的存储开销和数据规模的关系。我们也用大 O 符号来表示空间复杂度,例如O(1)、O(n)、O(n2)等。空间复杂度越小,算法的空间利用率越高。
查看常用排序算法的复杂度
| 排序算法 |
平均时间复杂度 |
最好情况 |
最坏情况 |
空间复杂度 |
排序方式 |
稳定性 |
| 冒泡排序 |
O(n2) |
O(n) |
O(n2) |
O(1) |
In-place |
稳定 |
| 选择排序 |
O(n2) |
O(n2) |
O(n2) |
O(1) |
In-place |
不稳定 |
| 插入排序 |
O(n2) |
O(n) |
O(n2) |
O(1) |
In-place |
稳定 |
| 希尔排序 |
O(nlogn) |
O(nlog2n) |
O(n2) |
O(1) |
In-place |
不稳定 |
| 归并排序 |
O(nlogn) |
O(nlogn) |
O(nlogn) |
O(n) |
Out-place |
稳定 |
| 快速排序 |
O(nlogn) |
O(nlogn) |
O(n2) |
O(logn) |
In-place |
不稳定 |
| 堆排序 |
O(nlogn) |
O(nlogn) |
O(nlogn) |
O(1) |
In-place |
不稳定 |
| 计数排序 |
O(n+k) |
O(n+k) |
O(n+k) |
O(k) |
Out-place |
稳定 |
| 桶排序 |
O(n+k) |
O(n+k) |
O(n2) |
O(n+k) |
Out-place |
稳定 |
| 基数排序 |
O(n⋅k) |
O(n⋅k) |
O(n⋅k) |
O(n+k) |
Out-place |
稳定 |
相关术语解释:
- 稳定:如果
a 原本在 b 前面,而 a=b,排序之后,a 仍然在 b 的前面
- 不稳定:不满足稳定定义
- 内排序(
In-place):所有排序操作都在内存中完成
- 外排序(
Out-place):由于数据太大,因此把数据放在磁盘中,而排序通过磁盘和内存的数据传输才能进行
- 时间复杂度:一个算法执行所耗费的时间
- 空间复杂度:运行完一个程序所需内存的大小
n:数据规模k:「桶」的个数In-place:不占用额外内存Out-place:占用额外内存
数据结构
栈与队列
-
栈是一种先进后出的线性表,JS中的数组可以实现一个栈(限定pop与push操作)。
constructor(length: number) {
if (!this.stack.length) {
console.error('Stack is empty!');
console.log(this.stack.pop());
if (this.stack[this.length - 1]) {
console.error('Stack is full!');
if (!this.stack.length) {
console.error('Stack is empty!');
return this.stack[this.stack.length - 1];
查看栈的应用,表达式的计算
中缀表达式计算问题
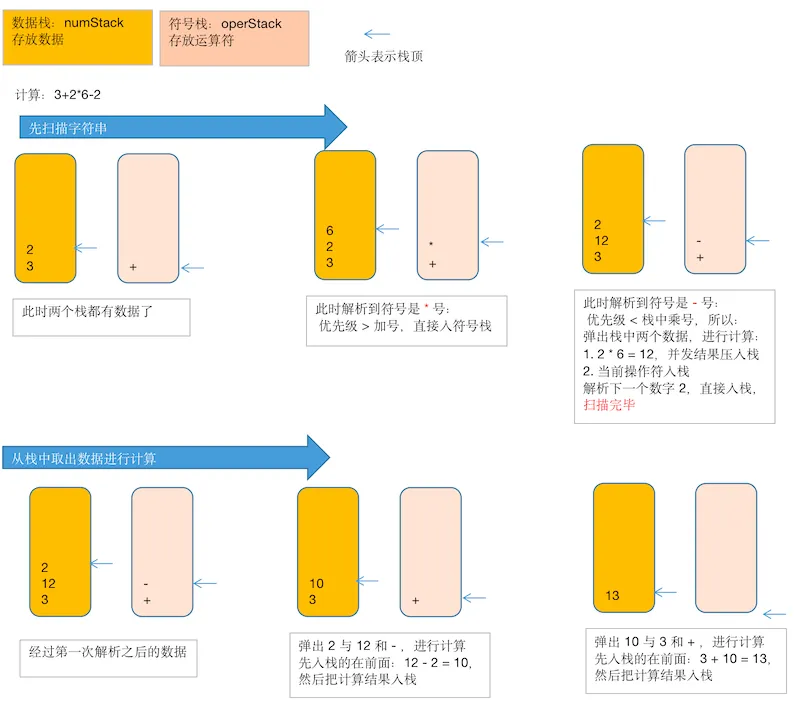
前缀表达式求值过程
-
从 右到左 扫描表达式
-
遇到 数字 时,将数字压入堆栈
-
遇到 运算符 时
弹出栈顶的两个数(栈顶和次顶),用运算符对它们做相应的计算,并将结果入栈。
计算顺序是:先 弹出来的 (运算符) 后 弹出来的
然后重复以上步骤,直到表达式的最左端,最后运算出的值则是表达式的值。
看完前缀表达式的计算逻辑,那么你要明白的是,从一个 中缀表达式 转换为 前缀表达式 时,优先级顺序是已经处理好的,因为在求值时,不进行优先级的判定
例如:(3+4)x5-6 对应的前缀表达式为:- x + 3 4 5 6,前缀表达式求值步骤如下:
-
从右到左扫描,将 6、5、4、3 压入栈
-
遇到 + 运算符时:
将弹出 3 和 4(3 为栈顶元素,4 为次顶元素),计算出 3 + 4 = 7,将结果压入栈
-
遇到 x 运算符时
将弹出 7 和 5,计算出 7 x 5 = 35,将 35 压入栈
-
遇到 - 运算符时
将弹出 35 和 6,计算出 35 - 6 = 29 ,压入栈
-
扫描结束,栈中留下的唯一一个数字 29 则是表达式的值
后缀表达式(逆波兰表达式)
后缀表达式 又称为 逆波兰表达式,与前缀表达式类似,只是 运算符 位于 操作数之后。
比如:(3+4)x5-6 对应的后缀表达式 3 4 + 5 x 6 -
再比如:
| 中缀表达式 |
后缀表达式 |
a + b |
a b + |
a + (b-c) |
a b c - + |
a+(b-c)*d |
a b c - d * + |
a+d*(b-c) |
a d b c - * + |
a=1+3 |
a 1 3 + = |
后缀表达式求值过程
-
从 左到右 扫描表达式
-
遇到 数字 时,将数字压入堆栈
-
遇到 运算符 时
弹出栈顶的两个数(栈顶和次顶),用运算符对它们做相应的计算,并将结果入栈。
计算顺序是:后 弹出来的 (运算符) 先 弹出来的
然后重复以上步骤,直到表达式的最右端,最后运算出的值则是表达式的值。
比如:(3+4)x5-6 对应的后缀表达式 3 4 + 5 x 6 -
-
从左到右扫描,将 3、4 压入堆栈
-
扫描到 + 运算符时
将弹出 4 和 3,计算 3 + 4 = 7,将 7 压入栈
-
将 5 入栈
-
扫描到 x 运算符时
将弹出 5 和 7 ,计算 7 x 5 = 35,将 35 入栈
-
将 6 入栈
-
扫描到 - 运算符时
将弹出 6 和 35,计算 35 - 6 = 29,将 29 压入栈
-
扫描表达式结束,29 是表达式的值
中缀表达式转后缀表达式
-
初始化两个栈:
-
从左到右扫描中缀表达式
-
遇到操作数时,将其压入 s2
-
遇到运算符时
比较 它 与 s1 栈顶运算符的优先级:
-
如果 s1 为空,或则栈顶运算符号为 ( ,则将其压入符号栈 s1
-
如果:优先级比栈顶运算符 高,也将其压入符号栈 s1
-
如果:优先级比栈顶运算符 低 或 相等,将 s1 栈顶的运算符 弹出,并压入到 s2 中
再重复第 4.1 步骤,与新的栈顶运算符比较(因为 4.3 将 s1 栈顶运算符弹出了)
这里重复的步骤在实现的时候有点难以理解,下面进行解说:
-
如果 s1 栈顶符号 优先级比 当前符号 高或则等于,那么就将其 弹出,压入 s2 中(循环做,是只要 s1 不为空)
如果栈顶符号为 (,优先级是 -1,就不会弹出,就跳出循环了
-
跳出循环后,则将当前符号压入 s1
-
遇到括号时:
-
如果是左括号 ( :则直接压入 s1
-
如果是右括号 ):
则依次弹出 s1 栈顶的运算符,并压入 s2,直到遇到 左括号 为止,此时将这一对括号 丢弃
-
重复步骤 2 到 5,直到表达式最右端
-
将 s1 中的运算符依次弹出并压入 s2
-
依次弹出 s2 中的元素并输出,结果的 逆序 即为:中缀表达式转后缀表达式
下面进行举例说明:
将中缀表达式:1+((2+3)*4)-5 转换为后缀表达式
| 扫描到的元素 |
s2(栈底->栈顶) |
s1(栈底->栈顶) |
说明 |
1 |
1 |
null |
遇到操作数直接压入 s2 |
+ |
1 |
+ |
s1为空,直接压入 |
( |
1 |
+ ( |
运算符为(,直接压入 |
( |
1 |
+ ( ( |
运算符为(,直接压入 |
2 |
1 2 |
+ ( ( |
遇到操作数直接压入 s2 |
+ |
1 2 |
+ ( ( + |
栈顶元素为(,直接压入 s1 |
3 |
1 2 3 |
+ ( ( + |
遇到操作数直接压入 s2 |
) |
1 2 3 + |
+ ( |
遇到)时,依次弹出 s1栈顶的运算符,并压入 s2 直到遇到 左括号 为止,此时将这一对括号 丢弃 |
* |
1 2 3 + |
+ ( * |
栈顶元素为(,直接压入s1 |
4 |
1 2 3 + 4 |
+ ( * |
遇到操作数直接压入 s2 |
) |
1 2 3 + 4 * |
+ |
遇到)时,依次弹出 s1栈顶的运算符,并压入 s2 直到遇到 左括号 为止,此时将这一对括号 丢弃 |
- |
1 2 3 + 4 * + |
- |
优先级比栈顶运算符 低或者相等 ,则弹出 s1栈顶元素,将其压入 s2 中,然后继续循环步骤 4,直至当前符号压入 s1 |
5 |
1 2 3 + 4 * + 5 |
- |
遇到操作数直接压入 s2 |
null |
1 2 3 + 4 * + 5 - |
null |
将 s1 的运算符依次弹出并压入 s2 ,结果的 逆序 即为:中缀表达式转后缀表达式的结果 |
由于 s2 是一个栈,弹出是从栈顶弹出,因此逆序后结果就是 1 2 3 + 4 * + 5 -
-
队列是一种先进先出的线性表,JS中的数组可以实现一个队列(限定push和shift操作)。
若要充分利用数组的空间,可实现一个环形队列的数据结构。
需要留一个空位的原因为:需要留出一个位置区分队列满与队列空的情况
- 队列为空:
front === rear。
- 队列为满:
(rear + 1) % maxSize === front。
- 队列长度:
(rear - front + Maxsize) % maxSize。
- 队列遍历:从
front累加size次,获取每次的arr[i % maxSize]的元素。
- 取队尾元素:注意考虑
rear索引为0的情况。
const readline = require('readline');
const rl = readline.createInterface({
constructor(maxSize: number) {
this.arr = new Array(maxSize);
return this.rear === this.front;
return (this.rear + 1) % this.maxSize === this.front;
this.arr[this.rear++] = el;
this.rear = this.rear % this.maxSize;
get(): number | undefined {
const el = this.arr[this.front++];
this.front = this.front % this.maxSize;
head(): number | undefined {
return this.arr[this.front];
tail(): number | undefined {
? this.arr[this.maxSize - 1]
: this.arr[this.rear - 1];
for (let i = this.front; i < this.size() + this.front; i++) {
const index = i % this.maxSize;
console.log(this.arr[index]);
return (this.rear + this.maxSize - this.front) % this.maxSize;
const queue = new CircleQueue(4);
const switchInput = (input: string) => {
rl.close(); // 关闭 readline 实例
rl.question('请输入一个数字', (line: string) => {
const result = queue.get();
result && console.log(result);
const result = queue.head();
result && console.log(result);
const result = queue.tail();
result && console.log(result);
console.log('空?' + queue.isFull());
console.log('您输入了无效的字符,请重新输入');
's(show): 显示队列\ne(exit): 退出程序\na(add): 添加数据到队列\ng(get): 从队列取出数据\nh(head): 查看队列头的数据\nt(tail): 查看队列尾的数据\np(isEmpty): 队列是否为空\n',
rl.on('line', (line: string) => {
链表
链表(Linked List)是一种物理存储单元上非连续、非顺序的存储结构,数据元素的逻辑顺序是通过链表中的指针链接次序实现的,由一系列结点(链表中每一个元素称为结点)组成
每个结点包括两个部分:一个是存储数据元素的数据域,另一个是存储下一个结点地址的指针域
注意反转链表的基本操作:
- 保存当前节点的下个节点(防止下一个节点丢失)
- 将当前节点插入道链表的头部。
- 将保存的下个节点取出,然后循环
public nickName?: string;
public next: ThiefNode | null;
constructor(no: number = 0, name?: string, nickname?: string) {
this.nickName = nickname;
return this.no + (this.nickName || 'HEAD');
this.head = new ThiefNode();
let temp: ThiefNode = this.head;
if (temp.next === null) {
if (el.no === temp.next.no) {
console.warn('Element already exists!');
let temp = this.head.next;
console.log(temp.toString());
addByOrder(el: ThiefNode) {
if (temp.next === null) {
} else if (el.no === temp.no) {
console.warn('Element already exists!');
} else if (el.no < temp.next.no) {
update(no: number, nickName: string) {
let temp = this.head.next;
console.warn('Thief not in this linked list!');
temp.nickName = nickName;
if (temp.next === null) {
console.warn('Thief not in this linked list!');
if (temp.next.no === no) {
temp.next = temp.next.next;
let temp = this.head.next;
lastIndexOf(num: number) {
const length = this.length();
console.warn('Index out of Range!');
const index = length - num;
for (let i = 0; i <= index; i++) {
let temp = this.head.next;
const newHead = new ThiefNode();
temp.next = newHead.next;
this.head.next = newHead.next;
let temp = this.head.next;
const stack: Array<string> = [];
stack.push(temp.toString());
for (let i = 0; i < stack.length; i++) {
console.log(stack[stack.length - i - 1]);
const hero1 = new ThiefNode(1, 'Amamiya Ren', 'Joker');
const hero2 = new ThiefNode(2, 'Ryuji Sakamoto', 'Skull');
const hero3 = new ThiefNode(3, 'Anne Takamaki', 'Panther');
const hero4 = new ThiefNode(4, 'Yusuke Kitagawa', 'Fox');
const singleLinkedList = new LinkedList();
singleLinkedList.add(hero4); // 添加顺序提前
singleLinkedList.add(hero2);
singleLinkedList.add(hero1);
singleLinkedList.add(hero3);
singleLinkedList.add(hero3);
singleLinkedList.delete(3);
singleLinkedList.print();
console.log(singleLinkedList.lastIndexOf(1).toString());
console.log(singleLinkedList.lastIndexOf(2).toString());
console.log(singleLinkedList.lastIndexOf(3).toString());
console.log(singleLinkedList.length());
singleLinkedList.reverse();
singleLinkedList.print();
singleLinkedList.reversePrint();
export default LinkedList;
树
-
二叉树
二叉树是一种树形结构,它的特点是每个节点最多只有两个子树,分别称为左子树和右子树。二叉树是有序的,也就是说,左子树和右子树的位置是不能互换的。二叉树是一种递归定义的结构,即一个二叉树要么是空的,要么是由一个根节点和两个非空的子二叉树组成。二叉树中的每个元素也称为一个节点,节点包含一个数据元素和若干指向子树的指针。
-
分类
- 满二叉树:如果二叉树中除了叶子结点,每个结点的度都为 2。
- 完全二叉树:如果二叉树中除去最后一层节点为满二叉树,且最后一层的结点依次从左到右分布。
-
二叉树的遍历
- 前序遍历:顶点 -> 左节点 -> 右节点
- 中序遍历:左节点 -> 顶点 -> 右节点
- 后续遍历:左节点 -> 右节点 -> 顶点
constructor(val, left, right) {
this.preOrder(root.left);
this.preOrder(root.right);
if (n.right) stack.push(n.right);
if (n.left) stack.push(n.left);
this.infixOrder(root.left);
this.infixOrder(root.right);
while (stack.length || p) {
this.postOrder(root.left);
this.postOrder(root.right);
while (stack.length > 0 || root) {
// 如果当前节点不为空,将其压入栈中,然后访问其左子节点
// 如果当前节点为空,说明左子树已经遍历完毕,取出栈顶节点
root = stack[stack.length - 1];
// 如果栈顶节点有右子节点,并且右子节点不是上一次弹出的节点,说明右子树还没有遍历,访问其右子节点
if (root.right && root.right !== lastPopNode) {
// 否则,说明左右子树都已经遍历,弹出栈顶节点,将其值加入结果数组,更新上一次弹出的节点,将当前节点置为空
const node1 = new TreeNode(1);
const node2 = new TreeNode(2);
const node3 = new TreeNode(3);
const node4 = new TreeNode(4);
const node5 = new TreeNode(5);
const node6 = new TreeNode(6);
const node7 = new TreeNode(7);
-
堆
堆是一棵完全二叉树,满足
- 堆中某个结点的值总是不大于或不小于其父结点的值
- 堆总是一棵完全二叉树
堆又可以分成最大堆和最小堆:
- 最大堆:每个根结点,都有根结点的值大于两个孩子结点的值
- 最小堆:每个根结点,都有根结点的值小于孩子结点的值
const temp = this.heap[i1];
this.heap[i1] = this.heap[i2];
this.shifUp(this.heap.length - 1);
const parentIndex = this.getParentIndex(index);
if (this.heap[parentIndex] > this.heap[index]) {
this.swap(parentIndex, index);
this.shiftUp(parentIndex);
this.heap[0] = this.heap.pop();
const leftIndex = this.getLeftIndex(index);
const rightIndex = this.getRightIndex(index);
if (this.heap[leftIndex] < this.heap[index]) {
this.swap(leftIndex, index);
this.shiftDown(leftIndex);
if (this.heap[rightIndex] < this.heap[index]) {
this.swap(rightIndex, index);
this.shiftDown(rightIndex);
图
在计算机科学中,图是一种抽象的数据类型,在图中的数据元素通常称为结点,V 是所有顶点的集合,E 是所有边的集合
如果两个顶点 v,w,只能由 v 向 w,而不能由 w 向 v,那么我们就把这种情况叫做一个从 v 到 w 的有向边。v 也被称做初始点,w 也被称为终点。这种图就被称做有向图
如果 v 和 w 是没有顺序的,从 v 到达 w 和从 w 到达 v 是完全相同的,这种图就被称为无向图
图的结构比较复杂,任意两个顶点之间都可能存在联系,因此无法以数据元素在存储区中的物理位置来表示元素之间的关系
常见表达图的方式有如下:
-
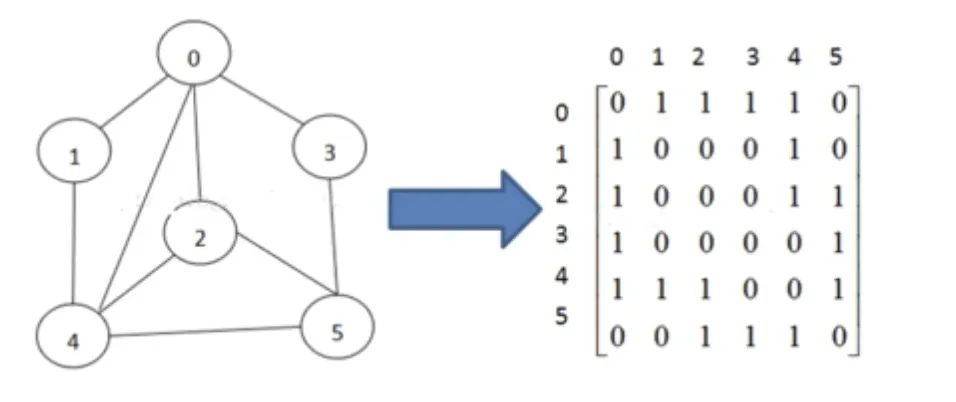
邻接矩阵
通过使用一个二维数组G[N][N]进行表示 N 个点到 N-1 编号,通过邻接矩阵可以立刻看出两顶点之间是否存在一条边,只需要检查邻接矩阵行 i 和列 j 是否是非零值,对于无向图,邻接矩阵是对称的。
-
邻接表
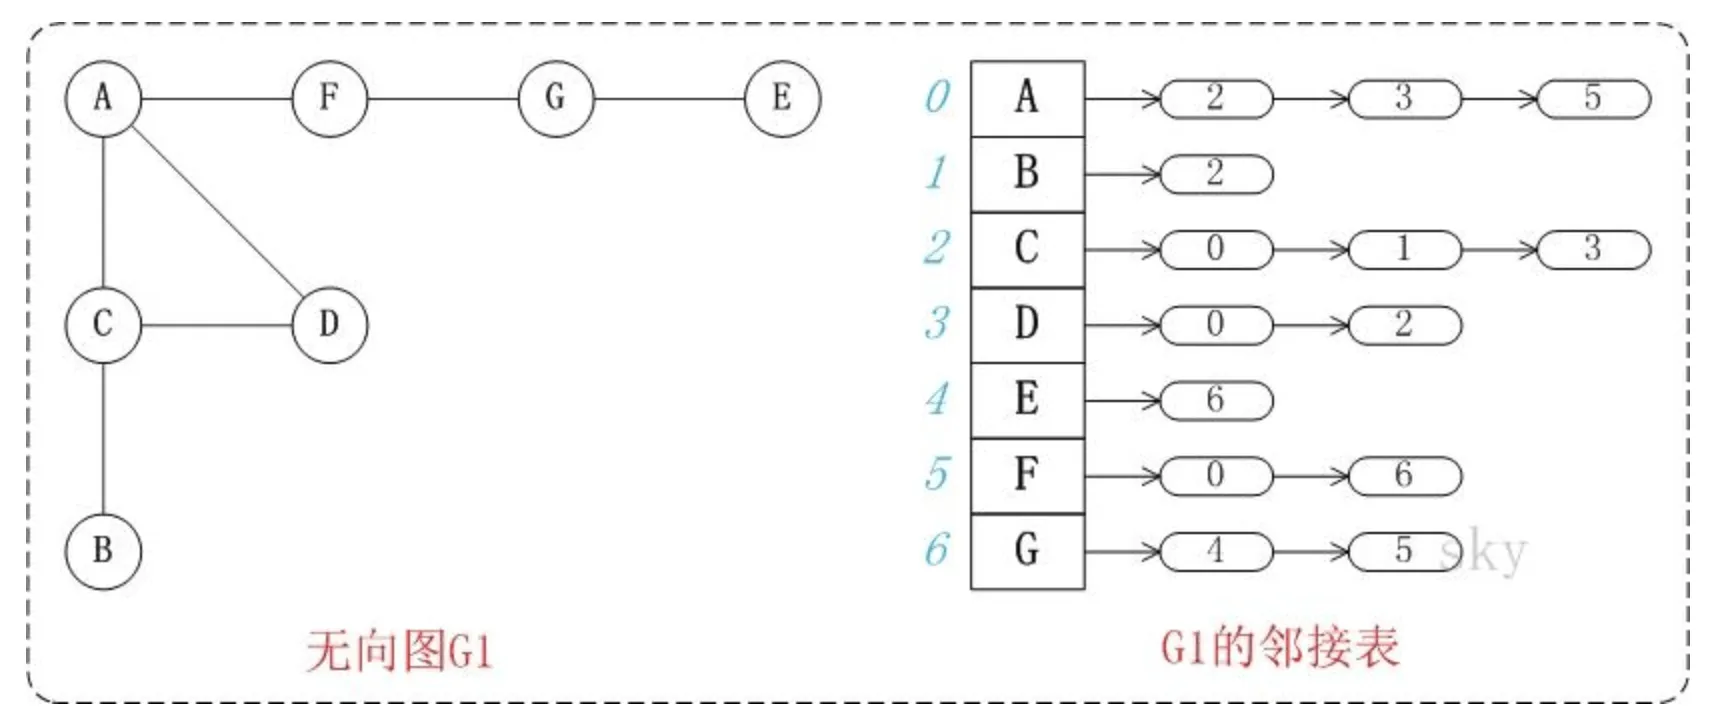
在JS中可以使用普通对象或者Map来表示
-
图的遍历
- 深度遍历:即遇到新节点就访问新节点,然后该节点上访问该节点的节点,也就是说尽可能往深处访问。
- 广度遍历:利用队列的数据结构。
const visit1 = new Set();
graph[n].forEach((el) => {
const visit2 = new Set();
graph[n].forEach((el) => {
常见算法
排序算法
-
冒泡排序
典中典,无需多言。
function bubbleSort(arr) {
for (let i = 0; i < len - 1; i++) {
for (let j = 0; j < len - 1 - i; j++) {
if (arr[j] > arr[j + 1]) {
let temp = arr[j + 1]; // 元素交换
-
选择排序
同样经典,无需多言
function selectionSort(arr) {
for (let i = 0; i < len - 1; i++) {
for (let j = i + 1; j < len; j++) {
if (arr[j] < arr[minIndex]) {
minIndex = j; // 将最小数的索引保存
-
插入排序
const insertSort = (arr) => {
const length = arr.length;
for (let i = 1; i < length; i++) {
while (pre >= 0 && current < arr[pre]) {
console.log(insertSort([2, 5, 6, 2346, 56, 47, 567]));
-
归并排序
const mergeSort = (arr) => {
const length = arr.length;
if (length < 2) return arr;
const middle = Math.ceil(length / 2);
let left = arr.slice(0, middle),
right = arr.slice(middle);
return merge(mergeSort(left), mergeSort(right));
const merge = (left, right) => {
while (left.length && right.length) {
if (left[0] <= right[0]) {
result.push(left.shift());
result.push(right.shift());
while (left.length) result.push(left.shift());
while (right.length) result.push(right.shift());
console.log(mergeSort([13, 27, 38, 49, 49, 65, 76, 97]));
-
快速排序
const quickSort = (arr) => {
if (arr.length <= 1) return arr;
for (let i = 1; i < arr.length; i++) {
return [...quickSort(left), mid, ...quickSort(right)];
const arr = quickSort([49, 38, 65, 97, 76, 13, 27, 49]);
查找算法
-
二分查找算法
const binarySearchFirst = (arr, target) => {
if (arr.length < 1) return -1;
const mid = Math.floor((low + high) / 2);
} else if (target < arr[mid]) {
if (mid === 0 || arr[mid - 1] < arr[mid]) return mid;
const binarySearchFirst2 = (arr, target, low = 0, high = arr.length) => {
if (low > high) return -1;
const mid = Math.floor((low + high) / 2);
return binarySearchFirst2(arr, target, low, mid - 1);
else if (arr[mid] < target)
return binarySearchFirst2(arr, target, mid + 1, high);
if (mid === 0 || arr[mid - 1] < arr[mid]) return mid;
return binarySearchFirst2(arr, target, low, mid - 1);
console.log(binarySearchFirst2([13, 27, 38, 49, 49, 65, 76, 97], 65));
动态规划
-
01 背包和无限背包问题
function knapsack(w, v, W) {
// w是物品重量数组,v是物品价值数组,W是背包总重量
let n = w.length; // 物品个数
let dp = new Array(W + 1).fill(0); // 初始化dp数组为全0
for (let i = 0; i < n; i++) {
for (let j = W; j >= w[i]; j--) {
dp[j] = Math.max(dp[j], dp[j - w[i]] + v[i]); // 状态转移方程
function knapsack1(w, v, W) {
// w是物品重量数组,v是物品价值数组,W是背包总重量
let n = w.length; // 物品个数
let dp = new Array(W + 1).fill(0); // 初始化dp数组为全0
for (let i = 0; i < n; i++) {
for (let j = w[i]; j <= W; j++) {
dp[j] = Math.max(dp[j], dp[j - w[i]] + v[i]); // 状态转移方程
let w = [2, 3, 4]; // 物品重量数组
let v = [3, 4, 5]; // 物品价值数组
let expected = 8; // 期望的输出结果
let actual = knapsack1(w, v, W); // 实际的输出结果
console.log('Expected:', expected); // 打印期望的输出结果
console.log('Actual:', actual); // 打印实际的输出结果
console.log('Test passed:', expected === actual); // 比较期望和实际的输出结果,打印测试是否通过
回溯算法
-
八皇后问题
private readonly N: number;
private arr: Array<number>;
console.log(this.order + ':' + this.arr.join(' '));
this.arr = Array.of(N).fill(0);
private judge(row: number) {
for (let i = 0; i < row; i++) {
this.arr[i] === this.arr[row] ||
row - i === Math.abs(this.arr[row] - this.arr[i])
public check(count: number) {
for (let i = 0; i < this.N; i++) {
const queen = new Queen8(9);
约瑟夫环问题
-
数组实现
// 定义一个函数,接受两个参数:n 表示人数,m 表示报数的最大值
function josephus(n: number, m: number): number {
// 创建一个长度为 n 的数组,用来存放每个人的编号,初始值为 1 到 n
for (let i = 0; i < n; i++) {
// 定义一个变量 index 来表示当前报数的人的索引,初始值为 0
// 定义一个变量 count 来表示当前报数的值,初始值为 1
// 定义一个变量 alive 来表示当前圆圈中还剩下的人数,初始值为 n
// 使用一个循环,当 alive 大于 1 时,重复以下步骤
// 如果当前报数的人的编号不为 0 ,说明他还没有被淘汰,那么就判断 count 是否等于 m
// 如果 count 等于 m ,说明他要被淘汰,那么就将他的编号设为 0 ,并将 alive 减 1 ,将 count 重置为 1
// 如果 count 不等于 m ,说明他还要继续报数,那么就将 count 加 1
// 将 index 加 1 ,并对 n 取模,以实现循环报数的效果
// 最后,遍历数组,找到那个编号不为 0 的元素,它就是最后留下的那个人的编号
for (let i = 0; i < n; i++) {
console.log(josephus(5, 3)); // 输出 4
console.log(josephus(41, 3)); // 输出 31